
Am 13. November 2026 stand der zivile Luftverkehr in den Vereinigten Staaten für mehr als vier Stunden beinahe vollständig still. Die Federal Aviation Administration (FAA) verhängte einen sogenannten Ground Stop – ein landesweites Startverbot. Ursache für diesen Zwischenfall soll ein Konfigurationsfehler während eines laufenden Modernisierungsprojekts der Netzwerkinfrastruktur gewesen sein.
Wenn veraltete Legacy-Systeme auf moderne Netzwerkarchitektur trifft
Eigentlich hätten die Cisco-Router der 6000er-Serie aus dem Jahr 2001 laut ursprünglicher Planung bereits 2006 stillgelegt werden sollen. 20 Jahre später wurde L3Harris beauftragt, diese Altgeräte durch aktuelle Router von Juniper Networks (heute Teil von Hewlett Packard Enterprise) zu ersetzen. Gleichzeitig fand eine Migration der physischen Netzwerkschicht von Kupfer- auf Glasfaserkabel statt. Wie sdx central berichtet, ging der Routertausch 68-mal gut.
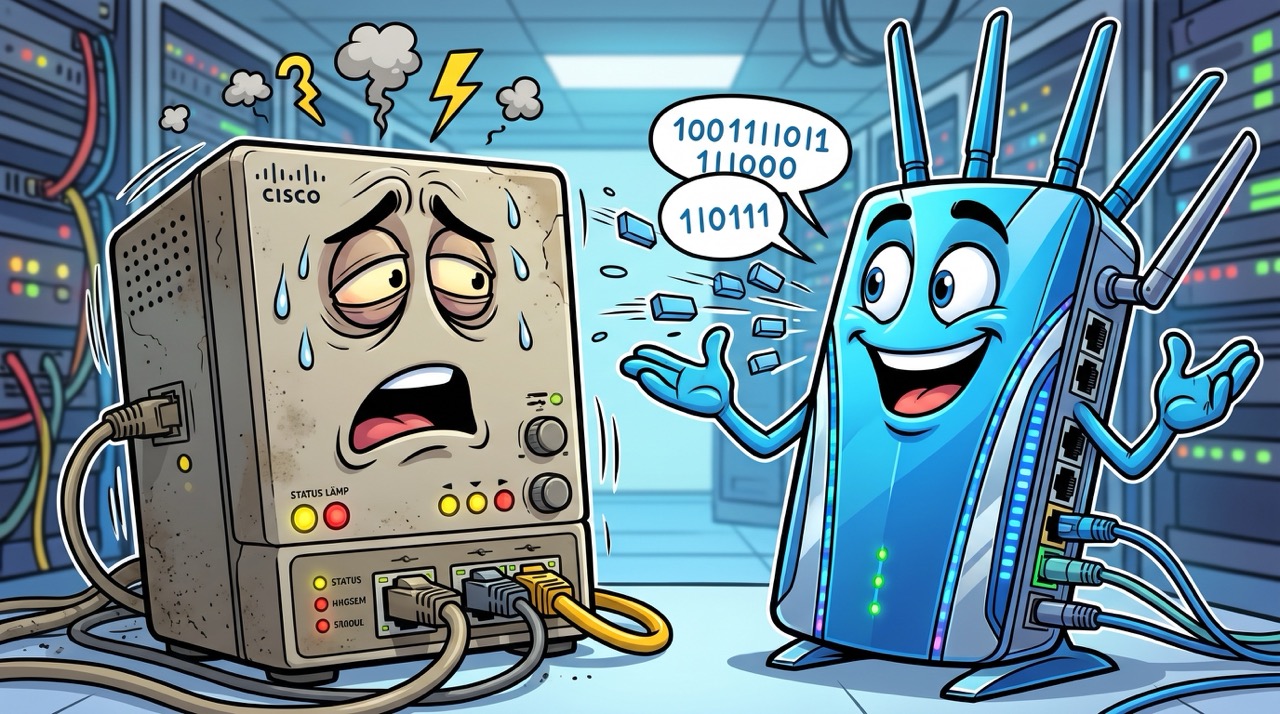
Dann begannen an zwei Standorten in Arkansas und Texas die neu installierten Juniper-Router, ein ungewöhnlich hohes Datenvolumen zu senden. Berichten zufolge handelte es sich um rund 1.000 Verbindungsversuche alle vier bis fünf Sekunden. Für moderne Netzwerkhardware eine triviale Last; für die noch nicht ausgetauschten Cisco-Komponenten im restlichen FAA-Netzwerk musste der Traffic jedoch wie eine interne Distributed-Denial-of-Service-Attacke (DDoS) gewirkt haben. Die in die Jahre gekommenen Geräte waren schlichtweg physisch nicht in der Lage, die Datenflut zu verarbeiten. Der Ausfall kaskadierte durch die gesamte Infrastruktur. Das System kollabierte und legte 17 der 22 regionalen Kontrollzentren der FAA (En-Route Centers) lahm, was etwa 77 Prozent der Kerninfrastruktur entspricht.
HPE betont, die Juniper-Router hätten exakt so funktioniert, wie sie vom Integrator konfiguriert worden seien. Es habe keinen Hardwaredefekt gegeben.
Die Risiken von Plattformmigrationen und Herstellerwechseln
Der FAA-Ausfall illustriert eine Archillesferse großer Transformationsprojekte in gewachsenen Enterprise-Umgebungen. Wenn Unternehmen ihre IT-Infrastruktur modernisieren, tauschen sie selten alle Komponenten gleichzeitig aus (Greenfield-Ansatz). Stattdessen erfolgt die Migration schrittweise im laufenden Betrieb. In solchen hybriden Brownfield-Szenarien müssen modernste Systeme mit teilweise jahrzehntealter Hardware kommunizieren.
Ein gleichzeitiger Technologiewechsel auf Hardware eines anderen Herstellers potenziert die ohnehin bestehende technische Komplexität. Cisco und Juniper nutzen grundlegend unterschiedliche Netzwerkbetriebssysteme, die Industriestandards und Routing-Protokolle unterschiedlich handhaben. Während proprietäre Funktionen und etablierte Konfigurationen des Alt-Herstellers über Jahre hinweg exakt an die spezifischen Workloads der Organisation angepasst wurden, können neue Systeme abweichende Standardeinstellungen, Architekturansätze und Leistungsmetriken mit sich bringen. Die Portierung von Konfigurationen und Skripten ist niemals eine 1:1-Übersetzung. Ein einziger falsch konfigurierter Parameter kann zu Routing-Schleifen oder Broadcast-Stürmen führen. Die Folge sind etwa Pufferüberläufe und CPU-Überlastungen auf den Legacy-Geräten. Die neue Hardware überfordert die alte schlichtweg durch ihre pure Effizienz.
Besonders kritisch wird das, wenn ein lokaler Fehler an Randstandorten (Edge) die Kerninfrastruktur (Core) eines weitreichenden Netzwerks gefährdet. Dass die Datenflut aus den beiden betroffenen Bundesstaaten ungebremst bis in die zentralen Kontrollzentren vordringen konnte, lässt auf Versäumnisse bei essenziellen Sicherheitsmechanismen wie strikter Netzwerksegmentierung, Systemhärtung bzw. standardisiertem Konfigurationsmanagement und effektivem Storm Control schließen.
Ein weiteres Risiko stellt der Integratorfaktor dar. Die Verantwortlichkeit verschwimmt häufig, wenn sowohl externe als auch interne Akteure beteiligt sind. Der Hardwarehersteller garantiert lediglich die Funktionsfähigkeit seiner Komponente. Der Integrator muss das funktionale Zusammenspiel der gesamten Architektur sicherstellen. Bei Plattformwechseln werden Konfigurationen häufig ohne ausreichende Tests auf die neuen Systeme übertragen. Was auf dem alten System fehlerfrei lief, löst auf der neuen Hardware aufgrund abweichender Parameter oftmals fatale Kettenreaktionen aus – und umgekehrt.
Lektionen für IT-Verantwortliche für Migrationen
Für Chief Information Officers (CIOs) und Chief Technology Officers (CTOs) liefert der Systemzusammenbruch bei der Luftfahrtbehörde wertvolle Erkenntnisse für ihre eigenen anstehenden Migrationsprojekte.
- Modernisierung erfordert temporäre Einschränkungen: Wenn Hochleistungshardware in eine Legacy-Umgebung integriert wird, sollte die neue Hardware zunächst nicht mit voller Kapazität betrieben werden. IT-Teams müssen striktes Rate Limiting und Traffic Shaping implementieren, um die Datenströme gezielt auf ein Niveau zu drosseln, das die ältesten und schwächsten Glieder der Kette verarbeiten können. Die Leistung der neuen Systeme muss künstlich an die Kapazitätsgrenzen der Altsysteme gekoppelt werden, bis die Umstellung vollständig abgeschlossen ist.
- Zero-Trust-Architektur und Netzwerksegmentierung sind essenziell: Der Blast Radius jedes Systems muss im Vorfeld klar definiert und technisch hart begrenzt werden. Kein lokaler Standort darf über die Berechtigung oder die physische Möglichkeit verfügen, Kernsysteme lahmzulegen. Das erfordert eine konsequente Isolierung der Netzwerksegmente sowie die Implementierung von Out-of-Band-Management-Zugängen. Letztere ermöglichen es Administratoren, im Krisenfall sofort einzugreifen, ohne auf das beeinträchtigte reguläre Datennetzwerk angewiesen zu sein.
- Staging und Simulation müssen die Realität exakt abbilden: Ein Proof-of-Concept (PoC), das lediglich aus den neuen Komponenten besteht, liefert keine aussagekräftigen Ergebnisse für eine reale Brownfield-Migration. Ausgiebige Tests müssen in isolierten Umgebungen stattfinden, die den exakten Zustand der produktiven Legacy-Infrastruktur widerspiegeln. Nur in solchen realitätsnahen Simulationen (Digital Twins) lassen sich Inkompatibilitäten und Überlastungsszenarien aufdecken, bevor sie den operativen Geschäftsbetrieb gefährden.
- Klare Verantwortlichkeiten bei der Systemintegration: Verträge mit Hardwarelieferanten und Integratoren müssen unmissverständlich festlegen, wer die finale Verantwortung für die Interoperabilität trägt. Hardwarehersteller verweisen bei Ausfällen stets auf eine möglicherweise fehlerhafte Konfiguration durch den Dienstleister. Das Unternehmen als Auftraggeber trägt letztlich das volle operative und finanzielle Risiko. Ein kompromissloses Change-Management, das jeden einzelnen Konfigurationsparameter validiert und freigibt, ist zwingend erforderlich.
- Technologische Schulden (Tech Debt) haben einen Preis: Die Tatsache, dass kritische Infrastruktur auf Routern betrieben wurde, deren Lebenszyklus vor zwei Jahrzehnten abgelaufen war, ist ein extremes Beispiel dafür. IT-Verantwortliche müssen ihren Budgetentscheidern unmissverständlich klar machen, dass das Hinauszögern von Hardware-Aktualisierungen nicht nur die Instandhaltungskosten in die Höhe treibt. Es erhöht das Risiko katastrophaler Systemausfälle bei unvermeidlichen künftigen Updates drastisch, da die technologische Lücke zwischen Alt und Neu irgendwann schlicht unüberbrückbar wird – abgesehen davon, dass es für die Senioren ab einem gewissen Zeitpunkt weder Herstellersupport noch Sicherheitsupdates mehr gibt.
- Strategisches Lieferantenmanagement erfordert Weitsicht: Organisationen müssen ihre Beschaffungsstrategien kontinuierlich evaluieren. Die vollständige Abhängigkeit von einem einzigen Hersteller (Vendor Lock-in) bei geschäftskritischen Komponenten erschwert komplexe Migrationsprojekte zusätzlich. Unternehmen müssen jederzeit die technische Hoheit über ihre Architektur behalten.
Fazit
Der Stillstand des US-Luftfahrtverkehrs war das direkte Resultat der Kollision zweier völlig unterschiedlichen IT-Epochen. Der Austausch von Enterprise-Hardware ist ein hochkomplexer architektonischer Eingriff. Brownfield-Migrationen müssen wie eine Operation am offenen Herzen behandelt werden. Unternehmen, die Plattform- und Herstellerwechsel planen, müssen der Risikoabschätzung, ausgiebigen Tests und der konsequenten Netzwerksicherheit in der Übergangsphase höchste Priorität einräumen.